



代码评审的瓶颈很少是”没人看出问题”,而是人手不够时只能在关键提交上抽查。把一份 diff 丢给通用对话模型逐行看,几百行之后它就开始丢上下文,给的意见还常常停在文件级,开发者得自己回去定位是哪一行。Open Code Review 是阿里巴巴把内部在用的代码审查 Agent 开源出来的版本,它把任务拆分、文件过滤、行号定位这类确定性工作交给工程模块,把风险判断与上下文探索交给 LLM Agent,产出的意见能落到具体行号上。站上给出的口径是集团内部 20K+ 活跃用户、已执行 3M+ 真实审查任务、npm 近 30 天下载 521K+。下面按定位、功能、场景、上手步骤和授权边界,说清它能覆盖到什么程度,以及哪些环节仍然要你自己把关。
Open Code Review 是什么?
它是一款运行在命令行的 AI 代码审查工具,由阿里巴巴开源,仓库采用 Apache-2.0 许可,2026 年 5 月建立,主仓以 Go 编写,目前在 GitHub 上有约 4.9 万星标、3600 多个 fork。产品形态是本地 CLI:`ocr review` 读取当前变更或指定提交范围,交给配置好的大模型做语义层面的风险识别,再输出带文件路径与行号区间的评论。它跟通用代码助手的主要区别在两点:一是内置了覆盖 40 多种语言与文件类型的审查规则集,NPE、线程安全、XSS、SQL 注入这类专项检查不依赖模型临场发挥;二是把”定位”与”审查”拆成两个模块,评论位置由独立模块用渐进式策略确定,而不是让模型自己报行号。它面向的是需要把审查动作嵌进本地流程、又要求代码不出内网的团队。
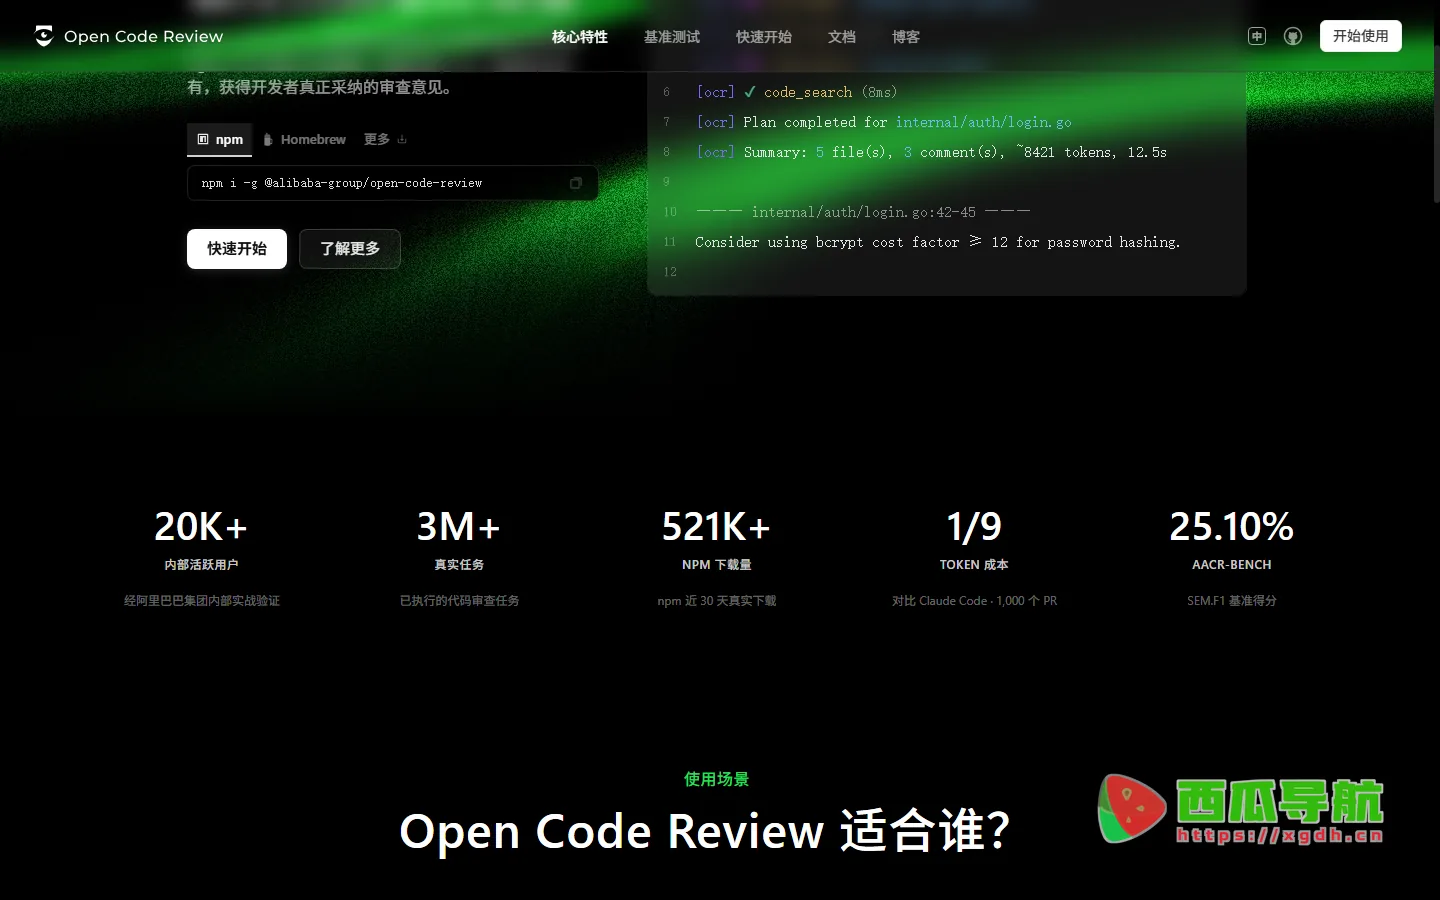
核心功能
它的设计取向是让模型少做机械劳动、多做语义判断。对每天要过几十个 PR 的团队,这意味着可以用更低的 token 成本换到更稳的意见;对个人开发者,则是一个可以随手挂在 `git` 工作流后面的检查环节。下面七项是站上列出的主要能力,基本对应了这套拆分的落点。
- 确定性工程与 Agent 解耦——任务拆分、文件过滤、行号定位、规则路由、异步调度由工程模块承担,模型只做风险检测与问题分类,质量、成本、速度三者不用二选一。
- 行级评论定位与独立反思——评论位置由专门模块按三级渐进式策略对齐到具体行号;另有一个反思模块提前拦掉幻觉式意见,减少”这条其实没毛病”的噪音。
- 多模型协议接入——同时支持 Anthropic Messages、OpenAI Chat Completions 与 OpenAI Responses 三套协议,内置 Anthropic、OpenAI、DashScope、DeepSeek、Z.AI 等预设,也能改指向自建的兼容端点。
- Effort 分档控制审查深度——`low` 适合提交前的快速反馈,`medium` 兼顾质量与成本,`high` 用于不容遗漏的关键变更;档位越高越会顺着已发现问题继续追问,一轮探索不再产出新风险时自动收敛。
- 三级分区记忆压缩——把上下文分成冻结、压缩、活跃三层管理,让超出单次窗口的大改动也能维持连贯的审查线索。
- 内置多语言审查规则——覆盖 Java、TypeScript、Go、Python、Kotlin、Rust、C/C++、Swift、Solidity、Verilog 等 40 多种语言与文件类型,规则来自真实场景沉淀而非通用提示词。
- 公开基准自证——自建 AACR-BENCH 基准,从 50 个热门开源仓库挑出 200 个真实 Pull Request,覆盖 10 种编程语言,由 80 多位资深工程师交叉验证,榜单与方法一并公开。
使用场景
审查这件事在不同角色手里差别很大:独立开发者把它当成提交前的自检,平台团队把它当成流水线里的一个环节,做模型训练的人则把它当成质量打分器。三种用法对”深度”和”可观测性”的要求正好相反,站上给出的三个典型人群也和这三种诉求对得上。
| 人群/角色 | 场景描述 | 推荐指数 |
|---|---|---|
| 独立开发者 | 本地改完一轮,提交前跑一次快速审查,先自己把明显问题改掉再开 PR | ★★★★★ |
| 平台团队 | 接入内部系统按自建规则出意见,模型端点指向私有部署,代码不出内网 | ★★★★★ |
| ML 研究者 | 作为训练流水线里的代码质量验证器,为生成结果提供判断信号 | ★★★★☆ |
| 后端工程师 | 改多文件涉及并发与数据库操作时,用 `high` 档把线程安全、注入风险一起过 | ★★★★☆ |
| 移动端与合约开发者 | 用 Kotlin、Swift、Solidity 的既有规则做语言相关检查 | ★★★☆☆ |
操作指南
整套上手只有三步:装、配、跑。因为不需要额外注册账号,只要有一个支持 Anthropic 或 OpenAI 协议的模型端点就能开始,第一次跑通通常在三分钟以内。前提是本机有 Node.js 环境,命令建议在项目根目录下执行,这样 `ocr` 才能正确识别仓库与变更范围。
- 打开 Open Code Review 的 快速开始 一节,先确认本机 `node` 与 `npm` 可用(版本要求以站点文档为准)。
- 全局安装:执行 `npm i -g @alibaba-group/open-code-review`;macOS 与 Linux 也可以用 Homebrew 安装。装完用 `ocr version` 验证是否生效。
- 配置模型:执行 `ocr config provider` 走交互式设置,从内置预设里挑一个再填 API Key。想手动指定就逐项写,例如 `ocr config set llm.url https://api.anthropic.com`、`ocr config set llm.auth_token` 填你的密钥、`ocr config set llm.model` 填模型名、`ocr config set llm.use_anthropic true`。
- 用 `ocr llm test` 验证连通性,这一步失败一般是密钥、端点路径或模型名不对,先把它修到通过再往下走。
- 跑第一次审查:在项目目录执行 `ocr review`,默认只看当前未提交的变更;要审查两个分支之间的差异用 `ocr review –from main –to feature-auth`;只审某个提交用 `ocr review –commit abc123`。
- 读结果时重点看三样:文件路径与行号区间、问题描述、以及 token 与耗时汇总。意见不认同可以直接忽略,它不会改动你的代码。
- 觉得结论太浅就把档位调到 `high` 再跑一遍;只想快速过一遍用 `low`,token 消耗和等待时间都会明显下降。
支持平台
当前以命令行工具形式交付,通过 npm 全局安装即可在 macOS、Linux、Windows 的终端里运行,macOS 与 Linux 另有 Homebrew 渠道,因此本质上是跟着 Node.js 环境走。仓库主语言为 Go,安装包与运行细节以官方文档为准。它没有网页版控制台、没有移动端 App、也不提供浏览器插件,审查对象是本地 Git 仓库里的代码,不涉及把整个项目上传到第三方界面。
产品定价
软件本身免费:仓库采用 Apache-2.0 许可,允许商用、修改与再分发,安装与使用不收取费用,也不需要额外注册账户。真正的成本在模型侧——审查消耗的是你所选 LLM 提供商的 token,按该厂商的计费规则结算,用自有部署的兼容端点则不产生外部费用。站上给出的对照是:同样处理 1000 个 PR,它的 token 成本约为 Claude Code 的九分之一,这也是它把确定性流程从模型里拆出去的直接收益。
常见问题
Q:代码会不会被上传到官方服务器?
不会经过官方中转。审查由你配置的模型端点执行,端点填哪家就发给哪家,填自建服务就只在内网流动;项目本身没有额外的托管服务,代码是否出网取决于你选的提供商。
Q:是免费的吗,会不会有隐藏收费?
工具免费且开源,采用 Apache-2.0 许可,商用也不需要授权费。需要花钱的只有大模型 token,这部分直接付给你选的模型厂商,价格随模型与审查量浮动。
Q:中文项目支持吗,有没有地区限制?
支持。站点提供中文界面与中文文档,审查语言不依赖代码里的注释语种。工具本身不绑定地区,只要能访问你所配置的模型 API 即可使用;若端点在某些网络环境下不通,换一个可用的提供商或自建端点就行。
开发者小结
它的价值集中在”把审查做到行级、把成本压在可接受范围”这两件事上:确定性流程与 Agent 分工让输出位置更准,三级记忆压缩让大改动不至于半途丢线索,多协议接入又避开了被单一厂商绑住。适合已经在用 Git 与命令行、希望审查环节留在本地或内网的团队,以及想给自检加一道关的个人开发者。不太适合两类需求:想要开箱即用的图形界面与团队看板的,它只有 CLI;指望它替代人工评审的,它也明确只做辅助判断,最终要不要改、改到什么程度仍由人定。另外它是 2026 年才开源的较新项目,规则集与模型适配都在快速迭代,正式接入前建议先在一两个仓库上跑一段时间,再决定放进流水线的哪个位置。
相关导航


