



把一个千亿级 MoE 模型塞进自己的机房,让它同时扛住吞吐和延迟,难点从来不在模型权重,而在模型之下那层东西:算子要针对具体芯片重写,专家并行要在超节点内把通信压下去,批调度要和设备执行重叠,KV 缓存要能留得够久、命中率才上得来。DeepInfer 是 DeepSeek 官方放出来的推理框架,公开说法是”支撑其大规模生产服务的那一套”,本次开源的是离线推理版本,包含大规模服务所需的核心能力。它目前只支持 DeepSeek-V4.1-Flash 一个模型,硬件只认 NVIDIA SM100 与华为昇腾 950 两条线,构建要自己编译,起步就是 64 卡加 64 卡。这些限制听起来很硬,但换来的是官方口径里那些真实数字:单集群每天 155 万亿 token、KV 缓存保留超过 72 小时、低谷时段每 GPU 小时 38 美元。下面把它到底解决什么问题、哪些能力已开源、哪些还得自己补,一条条拆开。
DeepInfer 是什么?
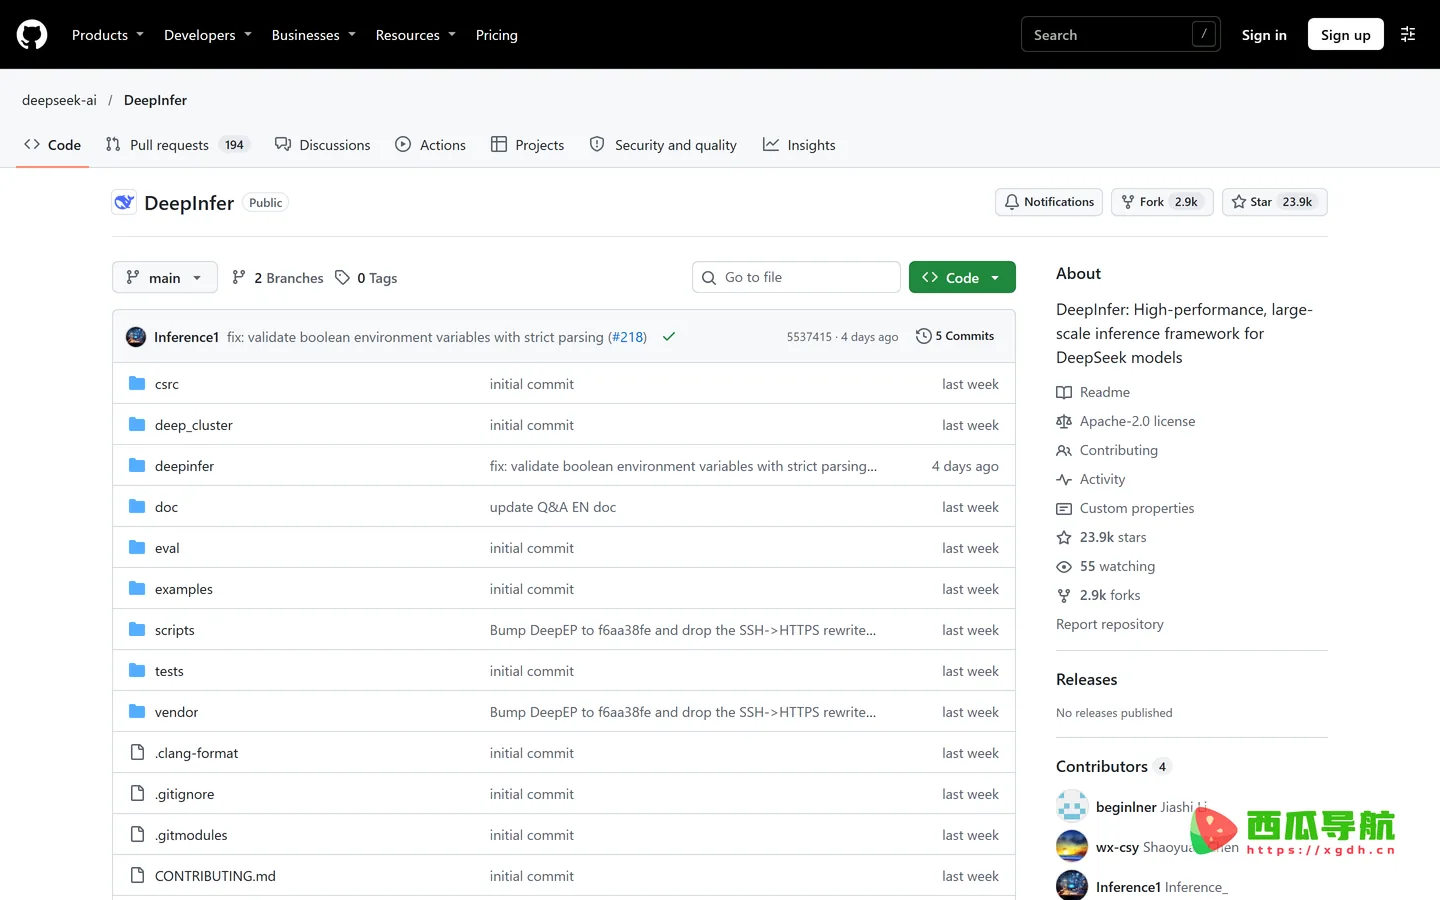
它是 DeepSeek 给自家模型配套的高性能推理框架,代码以 Apache-2.0 放出,Python 编写,版本号还停在 0.1.0、分类标着 Beta。仓库 2026 年 10 月中旬建立,两周多就攒到 2.3 万余 star、2,800 多 fork、220 条未结议题,但提交只有 5 次、贡献者 4 位——初始提交在 10 月 20 日,之后几天连续补文档与依赖修正,看起来是内部代码整理后一次性放出的形态。没有 tag、没有 release,也只能跟主干。
它对标的东西很清楚:不是通用的多模型推理服务,而是把 V4.1 Flash 这一个模型在两类加速卡上跑到位。官方在配套的部署问答里给了取舍原则:prefill 用普通 8 卡机、decode 用 64 到 128 卡超节点,算力按两个阶段的负载特性分别设计;不用张量并行与上下文并行,注意力走数据并行(DP 数量等于 EP 数量),MoE 部分走专家并行加负载均衡。这套结构决定了它能服务的规模,也决定了它对硬件的要求比一般框架高一截。
核心功能
特性清单分三层:算子层、并行与调度层、输出可控层。前者决定单卡能跑多快,后者决定结果能不能拿去做线上服务。
- 定制算子栈——FlashMLA、DeepGEMM、DeepEP、DeepSelect 加一批 TileLang 写的算子,六个子模块随仓库一起挂载,覆盖注意力、矩阵乘、通信与路由;这些是 DeepSeek 自己训模型时就在用的那套内核,不是通用实现。
- 双档并行——注意力用数据并行(DP 数量与 EP 对齐),MoE 用专家并行加 EPLB 动态重排;官方给的参考值是 prefill 用 EP2–8/DP2–8,decode 用 EP64–128 的宽专家并行,用更大的 EP 摊薄每步专家部分的内存访问。
- 推测解码——DSpark 加置信度调度验证,用草稿 token 加速解码,再用置信度估计决定验证哪些;`DEEPINFER_ENABLE_MTP_VARLEN=1` 打开,`DEEPINFER_USE_NEXTN_DECODE` 控制草稿长度,默认 5。
- SWA 有界重放——解码前的 prefill 只重放一段有界后缀,减少重复计算;V4.1 的默认档是 `DEEPINFER_YOCO_PREFILL_TRUNCATION_MODE=compact` 加保留 140 个 token,保留长度要盖住滑动窗口与最大回溯长度。
- 异步调度——CPU 侧的批调度与设备侧执行重叠,开箱即开,不用额外开关;这一步省下来的是每批之间的空转。
- 批次无关推理——不同批次组合下模型结果保持一致,`DEEPINFER_BATCH_INVARIANT=1` 打开(仅 NVIDIA);配合固定 `seq_seed` 与关闭变长推测,就能拿到确定性采样,同一输入同一参数每次输出相同。
- 结构化输出——把生成约束在正则、JSON Schema 或 EBNF 语法里,通过采样参数的 `so_args` 传 `schema_type` 与 `schema`。
- 两套验证入口——离线示例脚本带 PPL 回归与结构化输出自检,评测目录备了 AIME、GPQA、HLE 三套题,性能侧则给了 prefill 与 decode 两条 Pareto 曲线的复现脚本。
使用场景
它面向的不是”我想在笔记本上试试大模型”,而是”我要在机房里把 V4.1 Flash 跑出成本优势”。判断自己该不该看它,先看手里有没有 64 卡级别的一段连续算力。
| 人群/角色 | 场景描述 | 推荐指数 |
|---|---|---|
| 自建推理集群的工程团队 | 已经买了一批 SM100 或昇腾 950,想把 V4.1 Flash 跑出接近官方的吞吐 | ★★★★★ |
| 云与算力服务商 | 要对外提供 DeepSeek 模型服务,需要压单 token 成本、控 TTFT 与 TBT | ★★★★★ |
| 私有化交付集成商 | 客户要求模型留在自己机房,需要一套能编译、能测算、能回归的推理底座 | ★★★★☆ |
| 国产卡适配团队 | 想对照昇腾 950 上的实现路径,看 EP、EPLB 与通信怎么落 | ★★★★☆ |
| 推理方向研究者 | 研究宽专家并行、推测解码调度、批次无关性这些机制的工程实现 | ★★★★☆ |
| 个人开发者 | 想本地跑一个 DeepSeek 模型玩玩,没有对应加速卡 | ★☆☆☆☆ |
操作指南
流程是”先备环境、再编译、最后跑示例”,没有 pip 现成包,也没有容器镜像,全部从源码来。第一次跑会联网拉权重,内网环境要提前把权重放好。
- 打开 DeepInfer 仓库,先确认手里的卡在支持列表里:NVIDIA SM100 或者昇腾 950,别拿消费级显卡试。
- 备齐系统依赖:Linux 环境、GCC 13 以上、Python 3.12;NVIDIA 侧要 CUDA 13,昇腾侧要 CANN 9.2;依赖文件按平台分成了两份,不要混用。
- 建一个干净的 Python 3.12 虚拟环境并激活,官方明确要求是空环境,避免和已有 torch 版本打架。
- 声明加速器类型再编译:NVIDIA 用 `export DEEPINFER_ACCELERATOR=nvidia`,昇腾改成 `ascend`,然后执行仓库根目录的build.sh;这个变量要一直留在运行环境里。
- 跑第一个离线推理:`python examples/offline_inference.py`,默认权重会从 Hugging Face 缓存目录拉下来;纯离线机器用 `DEEPINFER_HF_MODEL_DIR` 指向本地副本,显式传 `–model_name` 时以传参为准。
- 按手里的卡数选并行组合:单机八卡用 `–ep 8`,两组八卡用 `–ep 2 –dp 8`,要试上下文并行用 `–ep 2 –cp 8`;参数细节用 `–help` 看。
- 要线上服务那类约束就改环境变量与采样参数:结构化输出传 `so_args`,确定性采样同时打开批次无关、关掉变长推测并固定 `seq_seed`。
- 需要对照性能或做回归时,用 `examples/sweep/run_sweep.sh` 复现 prefill 与 decode 曲线,用 `eval/run_eval.py` 跑 AIME、GPQA、HLE 三套评测。
支持平台
宿主只支持 Linux,没有 Windows 与 macOS 的构建路径,也没有官方容器镜像,这意味着本地调试只能在 Linux 机器或容器里做。加速卡两条线:NVIDIA 的 SM100 系列,以及华为昇腾 950 NPU;依赖版本卡得很具体——NVIDIA 侧要求 CUDA 13、torch 2.13.0+cu132、flash-attn-4 的 4.0.0b34,昇腾侧要求 CANN 9.2,两套依赖文件分开维护,构建脚本靠 `DEEPINFER_ACCELERATOR` 切换。模型侧只支持 DeepSeek-V4.1-Flash,默认权重是 1017 版;官方说明后续 DeepSeek 新模型的推理代码也会继续在这个仓库开源,但眼下没有多模型加载的余地。
产品定价
框架本身免费,Apache-2.0 授权,没有订阅、没有按卡或按 token 的授权费,权重从 Hugging Face 免费下载。真实的钱花在两处:一是硬件,官方给的参考是 decode 建议 EP64 以上,所以最小的高效部署单元是 64 卡 prefill 加 64 卡 decode,P 与 D 的卡数比大致 1:1;二是存储,KV 缓存要留 24 小时以上,官方建议每台存储服务器 20 块 30.73TB 固态,提供不低于 40GB/s 读、5GB/s 写,折算下来每张 GPU 对约 14.4TB 逻辑容量。官方在部署问答里披露,自有集群低谷时段每 GPU 小时的收入是 38 美元——这是他们对外服务的价格口径,不是本框架的收费,但可以拿来估算自建时的成本底线。
常见问题
Q:一张卡能不能跑起来,非得 64 卡起步吗?
技术上 1 个 prefill 实例加 1 个 decode 实例就能部署,但官方同时说明 decode 的推荐配置是 EP64 以上,原因是宽专家并行能显著降低每步 MoE 部分的内存访问量,卡少了这部分开销摊不开,吞吐上不去。所以一张卡或一台八卡机适合做流程验证、调通编译与示例,不适合拿来评估它真正的性能水平。至于显卡型号,支持列表只写了 SM100 与昇腾 950,消费级卡没有出现在里面。
Q:它和 vLLM 是什么关系,该选哪个?
官方在致谢里写得很直接:DeepInfer 最初主要基于 vLLM 构建,另外参考了 SGLang 与 TensorRT-LLM。区别在取向:vLLM 走通用路线,新模型支持快、生态大;DeepInfer 只服务 V4.1 Flash,把定制算子、宽专家并行、SWA 有界重放、批次无关性这些针对单一模型的优化做到很深。如果你的机房里跑的是这一个模型、且卡型对得上,它给出的是更贴近官方生产口径的实现;如果要跑一堆不同厂商的模型,通用框架仍然更省事。
Q:开源版缺了什么,能直接对外提供在线服务吗?
不能直接。README 明确列了三项”完整推理服务需要、但本次未包含”的东西:KV 缓存系统、视觉编码器/prefill/decode 的拆分部署(引擎侧大部分功能已实现)、以及 prefill 与 decode 数据并行副本之间的负载均衡。部署问答里也说了,KV 缓存管理与负载均衡这两块和内部基础设施耦合太紧,暂未完全开源。也就是说这个仓库给你的是引擎内核与调度,把它变成能对外卖的在线服务,还得自己补缓存、拆分与路由这三块。
开发者小结
它更像一份”官方生产系统的可编译切片”,而不是一个拿来即用的推理服务:内核、并行、调度、输出控制这几层给得很足,配套文档把并行配置、EPLB 参数、存储规格、跨机房带宽这些工程细节都摊开了写,连 moe_lb 这类均衡度指标都给了实测值,这种透明度在开源推理框架里不多见。代价同样清楚——只支持一个模型、只支持两类卡、Linux 专属、要自己编译、起步 64 加 64 卡,还缺 KV 缓存与负载均衡两块拼图;仓库两周多冲到两万多 star,但代码只有 5 次提交、4 位贡献者,社区能不能接住后续迭代还得看。适合已经在跑 V4.1 Flash、手里有对应算力的团队用来压成本;想在自己电脑上体验大模型的,这个方向从一开始就不对。
相关导航


