



AI 领域的二手解读有个通病:结论传得比原文快,细节在转述里一层层掉。想知道 Gemini 又更新了什么、Google Research 在押哪个方向、某个模型的能力边界到底在哪,看发布会通稿和科技媒体都不够——它们讲的是影响,不是具体做了什么。Google 的研究博客补的正是这一段:论文作者自己写,方法、实验设置、结论边界都在原文里,标签与年份归档也做得足够细,往回翻十几年不成问题。这篇讲清它现在的入口在哪、内容怎么组织、以及读它的时候要留意什么。
Google AI Blog 是什么?
它是 Google 官方发布研究进展的博客频道。需要先说明一个变化:早年独立使用的 AI 博客域名,现在访问会自动跳转到 Google Research 的研究博客,首页用一句 “The latest research from Google” 概括内容范围,导航分 Research、Resources、Conferences & events、Careers、Blog、About 六块,右上角带站内搜索。也就是说,这个入口现在归到了研究侧,而不是产品发布侧——它讲的是研究团队做出来的东西,不是产品团队上线了什么。内容组织有两个维度:Years 归档从 2026 一路排到 2006,共二十一年;Labels 有三十多个技术标签,从 Algorithms & Theory、Machine Intelligence 到 Quantum、Robotics、Responsible AI 都在列。每篇文章标注发布日期与一组标签,右上角提供 X、LinkedIn 与 RSS 三种跟进方式。
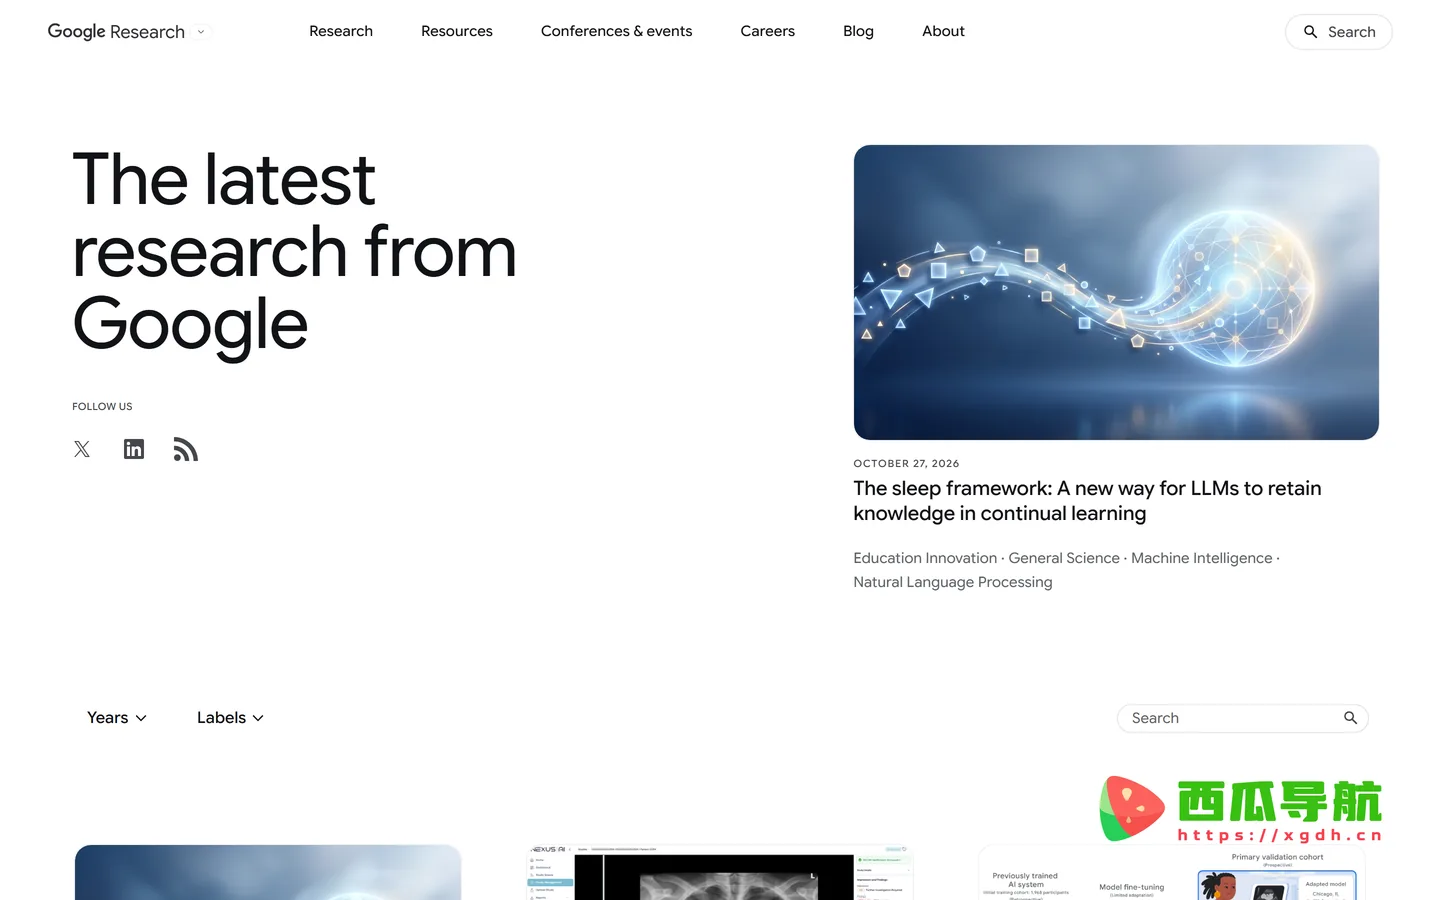
核心功能
它的功能就是研究与信息的分发,价值在分类颗粒度上。
- 二十一年按年归档——追溯某个方向的历史有据可查:Years 从 2026 排到 2006,想看某个技术从提出到成熟的完整脉络,按年份往回翻比搜索更系统。
- 三十多个技术标签——按方向横切内容:Machine Intelligence、Machine Perception、Natural Language Processing、Generative AI、Quantum、Robotics、Responsible AI 等标签各自独立,一个方向下的全部文章能一次拉出来。
- 一篇文章挂多个标签——跨领域研究不会被漏掉:以 2026 年 10 月那篇讲 LLM 持续学习的研究为例,它同时挂在 Education Innovation、General Science、Machine Intelligence、Natural Language Processing 四个标签下,从任一方向都能找到它。
- 研究型署名——知道是谁在做:文章由研究员本人撰写,方法与实验设置写得比产品博客细,能直接看到数据集、基线对比与失败案例。
- RSS 与社交两种跟进渠道——不用天天来刷:页面提供 RSS 地址与 X、LinkedIn 入口,技术雷达可以直接把 Feed 接进阅读器,不用每天来刷。
- 站内搜索配双筛选——精确到某标签某一年:搜索框与 Years、Labels 两个筛选可以叠加,范围能压得很窄。
使用场景
它适合需要准确信息的人,不适合想学怎么用 AI 的人。
| 人群/角色 | 场景描述 | 推荐指数 |
|---|---|---|
| AI 研究者与在读研究生 | 追方向、找原始论文线索,标签归档比通用搜索准 | ★★★★★ |
| 技术选型与架构师 | 判断 Google 在押哪些方向,评估长期依赖风险 | ★★★★★ |
| 科技作者与内容团队 | 引用一手来源,避免转述失真 | ★★★★★ |
| 算法工程师 | 看方法细节与实验设置,判断能不能迁移到自己的场景 | ★★★★☆ |
| 想学怎么用 AI 的普通用户 | 这里是研究进展,不是使用教程 | ★★☆☆☆ |
| 想第一时间知道产品上线的人 | 产品发布在另一条线上,这里滞后且不覆盖 | ★★☆☆☆ |
操作指南
完全开放,不需要账号,从进站到锁定目标内容是六步。
- 进站——入口是 Google AI Blog,旧地址会自动跳到 Google Research 的研究博客,收藏新地址更稳。
- 先定范围——要系统看某个方向就开 Labels 挑标签,要追时间线就开 Years 挑年份,两个筛选可以叠加。
- 用站内搜索——查具体模型名或方法名,搜索框比逐页翻快;注意用英文原词,中文译名在站内基本搜不到。
- 读标题下的标签行——每篇文章日期下方挂着一串标签,先扫标签判断是不是你要的那一类,再决定要不要读正文。
- 进正文看方法与实验——研究博客的价值在中段:数据集怎么构造、基线是什么、在哪些场景失效。这几段在二手报道里通常被砍掉。
- 订阅跟进——把 RSS 地址接进阅读器,或在 X、LinkedIn 上关注;做长期追踪的话 RSS 最省事。
支持平台
纯网页博客,任何现代浏览器都能读,没有登录墙与付费墙。移动端排版做了适配,长文可读。RSS 让它能脱离网页使用——把订阅地址加进阅读器即可。文章内嵌的图表与视频在低带宽下加载较慢,正文文字不受影响。站内搜索与 Years、Labels 筛选在桌面端操作更顺,手机上筛选器会折叠进菜单。
产品定价
完全免费。无账号、无订阅费、无付费墙,RSS 与社交跟进渠道同样免费。它承担的是官方研究信息发布职能,不承载商业转化。文章里提到的模型与数据集可能另有使用条款,但那属于各自项目的授权体系,与读博客这件事无关。
常见问题
Q:这个入口和 Google 官方博客的 AI 频道是一回事吗?
不是。旧域名现在指向的是 Google Research 的研究博客,内容以研究论文与方法为主。Google 另有一个官方博客站点,下设有 AI 相关频道,那一侧偏产品发布、功能上线与使用技巧。做技术选型两边都要看:研究侧判断方向,产品侧判断能不能马上用。混着看容易把“论文里有效”当成“产品里能用”。
Q:文章里的效果描述能直接当规格用吗?
不能。研究博客写的是实验条件下的结果,通常会标注数据集、模型规模与评测方法,这些条件在产品里未必成立。一个常见的误判是把论文里的最优指标当成线上表现,实际接入后受配额、延迟、上下文长度限制,差距不小。读博客定方向,读官方文档定参数,这两步不能合并。
Q:为什么有些文章在多个标签下重复出现?
因为一篇文章可以挂多个标签。跨领域研究本来就同时属于几个方向,比如一篇讲 LLM 学习机制的论文会同时出现在 Machine Intelligence、Natural Language Processing 与 Education Innovation 下面。按标签浏览时会看到重复条目,这是分类设计的结果,不是内容重复发布。
开发者小结
这个频道的价值在一手与可追溯两点:方法细节由研究者自己写,二十一年的年份归档与三十多个技术标签让追溯某条技术线变得可行,这一点是二手媒体给不了的。它也有清楚的位置——偏研究、偏英文、偏方法,产品发布与使用教程不在这里;文章的实验条件需要读者自己判断能否迁移;更新节奏跟着论文走,不保证某个方向有连续覆盖。适合做技术雷达的研究者与需要准确引用的作者;想学怎么用 AI 的话,这里不是起点。
相关导航


