给服务做健康检查,人们习惯用一个返回码来判定生死。HTTP 200 就表示正常,超时或非 200 就表示故障,这套逻辑简单直接,也确实支撑了大量传统网站的运维。可当被监控的对象换成大模型中继服务,情况就变了:请求确实返回了 200,响应体却可能是空的、被拦截的,或者干脆是一段错误信息。监控面板一片绿色,真实调用方却拿不到有效结果。这种误报不会触发任何告警,也不会有人注意到,直到业务侧开始抱怨。RelayPulse 就是在这样的落差里被做出来的,它把判断标准从连通性挪到了内容本身,让可用性这件事重新有了可信的度量。
RelayPulse是什么?
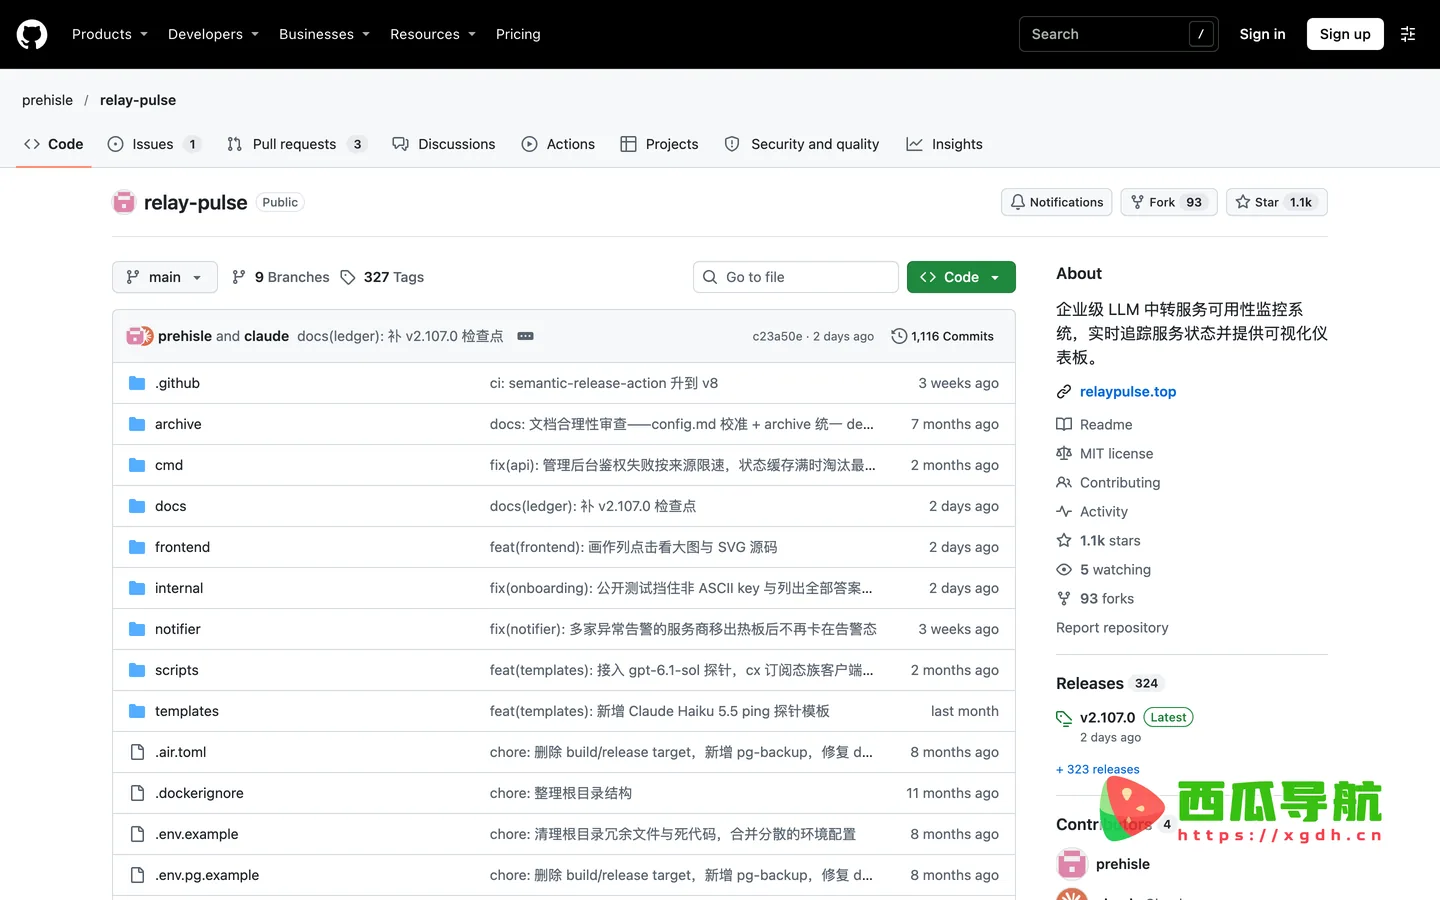
RelayPulse是一个基于真实 API 调用的大模型服务质量监控工具,主要用来持续核验 LLM 中继服务的可用性,服务于自建或采购中继服务、需要可靠 SLA 证据的开发者与团队。它和常见连通性监控工具的分歧点在于判定依据:前者只确认端口与状态码,本项目则消耗真实令牌发起请求,并校验返回内容是否真的由模型产出,只有模型确实给出了有效回答,这一次探测才算通过。项目以精简镜像交付,配置与密钥默认留在本地或自托管环境,不向外发送数据,适合把监控数据握在自己手里。
核心功能
- 真实 API 探测——每次检查都消耗真实令牌并校验响应内容,把空返回和错误响应挡在可用状态之外,明显减少误报。
- 可视化可用性矩阵——按 24 小时、7 天、30 天三个时间窗展示可用性热力图,服务波动一眼可见,不必逐条翻日志。
- 配置热重载——借助 fsnotify 监听配置文件变化,改完即时生效,不用重启进程打断正在进行的探测。
- 多种存储后端——单机开发用 SQLite 零配置直接跑,K8s 多副本场景切到 PostgreSQL,支撑高可用与横向扩展。
- 云原生部署——镜像体积精简,天然适合容器化与水平扩容,部署形态跟着业务规模走而不用重写架构。
- 低探测成本——单次探测把 max tokens 设为 1,约二十个输入令牌加一个输出令牌,默认每分钟一次,单服务每天约三万令牌。
- 本地数据留存——配置与密钥只保存在本地或自托管环境,数据不外发,隐私边界由使用者自己掌握。
使用场景
| 人群/角色 | 场景描述 | 推荐指数 |
|---|---|---|
| 自建或采购中继服务的运维者 | 对自建或买来的 LLM 中继做持续 SLA 核验,用真实响应替代状态码判断 | ★★★★★ |
| 多云服务选型的架构师 | 横向比较不同提供方的延迟与错误率,把可用性差异摆到台面上 | ★★★★☆ |
| 依赖外部 API 的应用开发者 | 监控上游依赖,避免误报引发的无效停机与排查 | ★★★★☆ |
| 容器平台的运维工程师 | 在 Kubernetes 中多副本部署,配合 PostgreSQL 做高可用与横向扩展 | ★★★★☆ |
| 重视数据留存的团队 | 配置与密钥本地保存、数据不外发,满足自托管的数据掌控需求 | ★★★★☆ |
| 需要稳定数据接入的分析者 | 按固定间隔取样做趋势分析,并以最近 24 小时真实可用性作参考 | ★★★☆☆ |
操作指南
- 先确认手上的服务已经提供可用的 API 入口与访问密钥,把待监控的服务逐条列出来,明确每个目标的探测地址和鉴权方式,这是后续所有配置的基础。
- 打开项目主页 RelayPulse,通读说明文档与入门指引,弄清探测频率、令牌上限以及响应校验的基本约定,再决定要不要按默认参数起步。
- 按推荐方式用容器镜像启动服务,把配置文件挂载进去,先只接入一个监控目标做小范围试跑,观察探测记录是否与实际可用性一致。
- 服务跑起来后进入面板入口,点击 立即使用 查看监控视图,确认 24 小时可视化矩阵开始积累数据,并核对首次探测的耗时与判定结果。
- 逐步补齐其余监控目标,按需在 SQLite 与 PostgreSQL 之间选择存储后端;单机开发保持默认即可,多副本部署再切到数据库。
- 调整探测间隔时要留意取样口径:每次请求的时间基线不同,时间桶边界会有轻微漂移,需要稳定数据就按固定间隔取样,并以最近 24 小时的真实可用性作为排序依据。
- 需要改配置时直接编辑文件,热重载会让改动即时生效,不必重启;随后观察一段运行期,确认告警与矩阵变化对得上真实故障。
支持平台
从已公开的信息看,项目提供 Web 形态的在线演示与 API 接口,主体以 Docker 镜像交付,既能单机独立运行,也能在 Kubernetes 中多副本部署;存储侧支持 SQLite 与 PostgreSQL 两种后端。站方没有明确列出桌面客户端、移动端小程序或浏览器插件,这部分以项目后续更新为准。
产品定价
站方未公开价格信息,以站内为准。项目作为开源项目在代码托管平台公开,文档里没有给出具体收费档位,只提供了赞助档位说明与收录协议的入口。真正会产生消耗的是探测请求本身:单次约二十个输入令牌加一个输出令牌,默认每分钟一次,单服务每天大约三万令牌,这部分取决于接入方自己的调用额度。
常见问题
Q:它和普通连通性监控有什么不同?
连通性监控看的是状态码与端口,返回 200 就算通过;RelayPulse 会消耗真实令牌发请求,并校验响应内容是否真的来自模型,空响应、错误体都不会被算作可用,因此更适合大模型中继这类场景。
Q:探测会不会花掉很多令牌?
单次探测把 max tokens 设为 1,约二十个输入令牌加一个输出令牌,默认每分钟一次,单服务每天大约三万令牌,对多数自建或采购场景来说负担很轻,具体仍取决于接入的服务数量。
Q:为什么可用性矩阵的时间边界看起来在浮动?
每次请求的时间基线不同,落桶边界会有轻微偏移,这是取样口径带来的正常现象。若要对接稳定的数据流,建议按固定间隔取样,并以最近 24 小时的真实可用性作为提供方排序依据。
开发者小结
选型上,RelayPulse 的价值是把可用性判断从状态码拉回到内容本身,适合已经在使用或自建 LLM 中继、并且需要拿得出 SLA 证据的团队;代价是探测要花令牌、要维护配置文件,还得接受时间桶边界浮动带来的数据抖动。如果目标只是知道服务是否可达、端口是否开放,传统连通性工具更省事;如果监控对象本身不返回可校验的结构化内容,内容核验的优势也发挥不出来。它更像是中继服务这条链路上的质检环节,而不是通用监控的替代品,把边界划清楚之后用起来才顺手。
相关文章