

读古籍最难的一步从来不是读,而是找到可信的版本。想查一句《史记》原文,搜出来的常常是后人转帖、错字夹着缺行;想核对《汉书》某段注疏,得跑去图书馆翻影印本;想看看《菜根谭》不同批注本的差别,更是无处下手。识典古籍试图把这件事整体搬到浏览器里:它自称收录 74567 部古籍,标点、校勘、注释都做了数字化处理,同一段文字可以对照不同注本,还配了 AI 辅助的深度研究与内容核查。它不是影印扫描件仓库,而是把整理好的文本重新组织成可检索、可对照、可引用的结构。本文说明它到底能查到什么、三大平台各管一段什么、以及哪些期待要先放低。
识典古籍是什么?
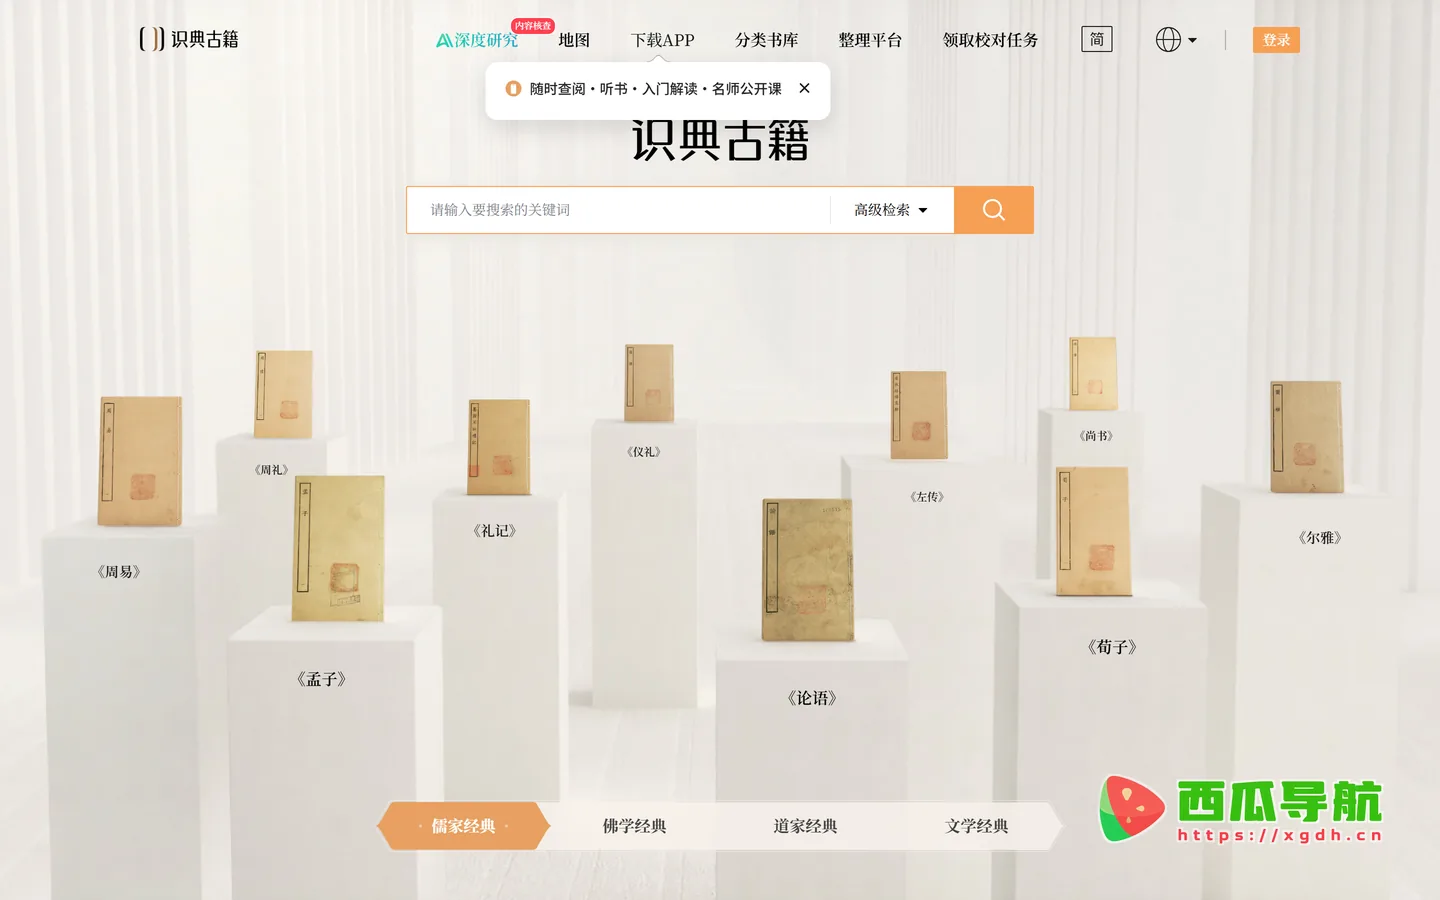
它是字节跳动旗下的古籍数字化平台,域名 shidianguji.com,由三部分组成:网页端的古籍阅读研究平台、古籍整理平台、以及同名手机 App。首页顶部是一条横排功能栏:深度研究、内容核查、地图、下载 APP、分类书库、整理平台、领取校对任务,右侧是简繁切换与登录。正文区先给十个高频书名——资治通鉴、永乐大典、天工开物、三命通会、册府元龟、红楼梦、三国志、明实录、太平御览、史记,紧接着一行主推数字:共收录 74567 部古籍。分类维度分儒、释、道、文学四路,另有高级检索支持按书名、作者精确查。专题区是按主题拼好的书单,例如“缓解焦虑不内耗”7 本 266 人收藏、“跟毛主席读古籍”10 本 681 人收藏、“二十五史”25 本 829 人收藏。站点自述合作单位是北京大学《儒藏》编纂与研究中心,也承接了全国古籍整理出版规划领导小组办公室首批推荐的 40 种经典古籍。
核心功能
它的价值集中在“版本”和“检索”这两件事上。
- 74567 部古籍一次可查——不用在多个书库之间来回跳:体量是它最硬的一项指标。分类书库按经史子集与释道分线,也可以直接走高级检索,用书名或作者定位到具体一部。
- 多注本并列——同一段话能看到历代不同人的理解:以《史记》为例,页面标注的整理来源是“[西汉] 司马迁 撰、[宋] 裴骃 集解、[唐] 司马贞 索隐、[唐] 张守节 正义”,三家注齐全;《三国志》带裴松之注,《汉书》带颜师古注,《老子道德经》用河上公注本。想比较注家差异,不用自己凑版本。
- 标点与校勘到位——不是简单 OCR 堆上去的文本:整理条目会写明校注者,例如《菜根谭》标“[明] 洪应明 撰、[明] 汪乾 初校”,《庄子》标“[西晋] 郭象 注、[唐] 陆德明 音义、[清] 孙毓修 札记”。这层信息决定了引用时能不能交代清楚底本。
- AI 深度研究与内容核查——把检索升级成问答:首页导航里有“深度研究”与“内容核查”两个入口,结合古籍语料做语义层面的问答与出处核对,适合查“这句话最早出自哪本书”这类问题。
- 地图与听书——两种非阅读型入口:站点提供古籍相关的地理可视化,以及 App 端的听书、入门解读、名师公开课。读不下去原文的时候,这些是降低门槛的替代路径。
- 协作整理与校对任务——普通人也能参与:整理平台是协作式的全流程工具,任何人都可以领校对任务,做完计入贡献。这是它区别于普通电子书库的地方:文本在被持续修订。
使用场景
| 人群/角色 | 场景描述 | 推荐指数 |
|---|---|---|
| 中文系与历史系学生 | 查原文、比对注本、拿可交代底本的文本做引用 | ★★★★★ |
| 写作者与文案 | 找典故出处,核对引文是否被转帖改错 | ★★★★★ |
| 国学爱好者 | 按专题书单入门,从《菜根谭》《浮生六记》这类短篇读起 | ★★★★★ |
| 古籍整理与校对从业者 | 用整理平台协作标校,领取校对任务 | ★★★★☆ |
| 只看影印本的人 | 站点以整理文本为主,影印扫描件不是它的主线 | ★★☆☆☆ |
| 要做严肃版本学研究的人 | 需要核对善本原件、版式与递藏,仍得回图书馆 | ★★☆☆☆ |
操作指南
从进站到读到正文,五个动作。
- 进站——打开 识典古籍,首页不用登录即可检索与阅读。
- 选路——知道自己要哪本书,直接用顶部检索,或进“高级检索”按书名、作者定位;不知道读什么,就从分类书库按儒释道与文学四路挑,或者看专题推荐里别人整理好的书单。
- 读正文——进入书籍页面后是整理好的全文,注文与正文分层显示。需要引用的句子,先看页面上标的撰者与注家,把底本信息一起记下来。
- 做深查——要追一句引文的来龙去脉,用“深度研究”做语义检索;要确认某段话是否真出自某书,用“内容核查”对出处。
- 参与校对——首页有“领取校对任务”入口,进任务中心可以挑一段文本做标校,适合想练手或想给平台添砖的人。
支持平台
网页端在桌面与手机浏览器上都能正常阅读,长文竖排与注文对照需要足够宽度,做研究建议用电脑;手机浏览器能读,但注文与正文的分层会挤在一起。另有同名 App,官方给的差异是 App 多了听书、入门解读与名师公开课,适合通勤时用。全程不需要安装插件,也不强制登录,读与查都能在游客状态完成;要参与校对则必须注册账号。
产品定价
阅读、检索、校对这些核心功能免费,不需要付费订阅,也不需要机构账号。整理平台面向公众开放,领取校对任务同样不收费。App 端的听书与公开课也以免费为主。这套模式意味着它更接近公共文化基础设施,而不是内容付费产品——也意味着它的更新节奏取决于整理志愿者的投入,冷门书的文本质量可能不如热门典籍。
常见问题
Q:74567 部这个数字包括影印本吗?
从站点呈现方式看,它主打的是经过标点与校勘的整理文本,书籍页会标注撰者、注家与校注者,而不是直接给扫描图。影印善本的查阅不在它的主线上,需要看原刻版面、避讳字、递藏印的,得去专门的古籍影像库或图书馆。
Q:引文可以直接照抄吗?
文本可用,但引用时要交代底本。每本书的页面都写了撰者与注家信息,比如《史记》是三家注本、《汉书》是颜师古注本,同一句话在不同注本里断句与释义可能不同。学术写作建议注明“据识典古籍整理本,底本为某某注本”,把版本链条留清楚。
Q:整理平台和阅读平台是什么关系?
两个入口,一套数据。阅读平台是消费端,给普通读者查书、读书、做研究;整理平台是生产端,给志愿者和机构做标点、校勘、注释,做完的成果回流到阅读端。首页的“领取校对任务”就是把公众接进生产端的入口。
开发者小结
识典古籍真正解决的是古籍数字化的“最后一公里”:把散在各处的底本、注本、校勘记整理成一套能检索、能对照、能引用的结构化文本,并且明确标注每一层的来源。74567 部的体量加上三家注、裴注、颜注这类完整注本,让它足以撑起日常查证与入门阅读的绝大多数需求;AI 深度研究与内容核查把“找一句话的出处”从翻书变成了提问。它解决不了的是版本学的深水区:善本原貌、版式差异、递藏源流,这些仍然要回图书馆看原件。使用时养成一个习惯——读完一段先看页头的撰者与注家,把底本信息一起记下来,这比记住结论更有用。
相关文章


