

想给一段视频换中文配音,或者让一段文字用自己的声音念出来,常见做法是订阅云端语音服务:按字符计费、参考音频要上传到别人的服务器、断网就用不了。另一条路是直接跑开源模型,但环境、CUDA、权重、批量脚本都得自己拼,半天搭不完还可能卡在依赖冲突上。VoiceStudio 把第二条路做成了一个桌面应用——Electron 外壳加本地推理后端,装上就是一个带界面的语音工作台,克隆、设计、配音、听写、有声书都在同一个窗口里,模型按需下载,不用账号也没有用量表。它把「音频不出本机」当作卖点,也确实把联网限制在检查更新与下载模型两件事上。下面讲清它具体能做什么、装起来要多少空间、免费版和 Pro 到底差在哪,以及哪些环节的许可条款容易踩坑。
VoiceStudio 是什么?
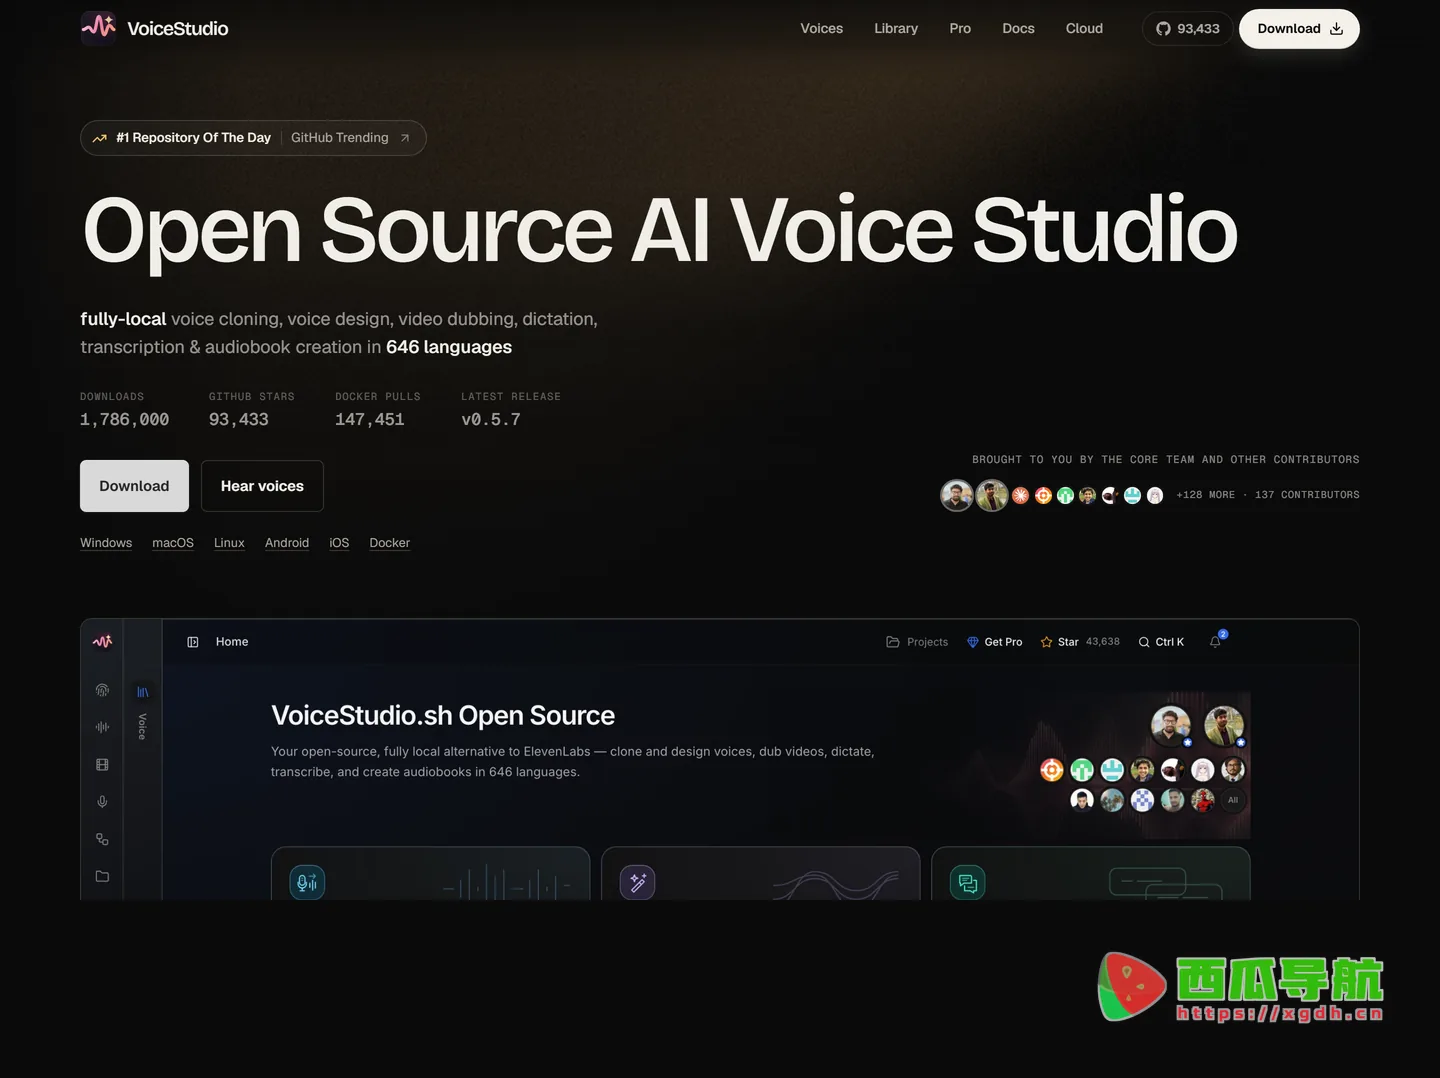
VoiceStudio 是一个开源的本地 AI 语音工作台,许可协议为 AGPL-3.0,作者是 Palash Debnath,仓库 2026 年 4 月创建,当前版本 v0.5.7。它在 GitHub 上有 93,433 星、10,340 个 fork 与 137 位贡献者,官网显示累计下载 178.6 万次、Docker 镜像拉取 14.7 万次。默认推理引擎是 k2-fsa 的 OmniVoice,模型管理器里另收录 CosyVoice 3、IndexTTS 2.5、GPT-SoVITS、KittenTTS、MOSS-TTS 等十余款合成引擎,以及 WhisperX、Faster-Whisper、FunASR、Parakeet 等转写引擎。与云端语音服务相比,它的推理在本机、音频不上传、不按字符扣费;与直接跑开源模型脚本相比,它把 Python 环境、FFmpeg、权重下载、批量队列与导出都收进了一个应用里。
核心功能
功能围绕「一段声音从无到有」的完整链路铺开:先克隆或设计出音色,再合成、配音、转写,最后批量导出。它照顾的是需要自己产出音频、又不愿把素材交给云端的人;如果你只是偶尔转一段语音,装一个浏览器工具可能更省事。
- 音色克隆——给一段干净的参考录音就能复刻音色,官方说三秒左右的清晰音频通常够了,克隆在本机完成。
- 音色设计——用一句话描述性别、年龄、口音、音高与情绪直接生成音色,不需要任何参考音频。
- 视频配音——转写、翻译、重新配音一条链路走完,每个说话人单独处理,语音时间轴与原片对齐。
- 听写与转写——桌面浮窗做实时听写,长音频走本地转写,适合会议记录与访谈整理。
- 有声书与批量队列——故事、有声书、待处理任务排队跑,不必守着每一条点生成。
- 引擎与模型管理——默认 OmniVoice,也可在同一处切换其他合成与转写引擎,只下载用得上的权重。
- 人声分离与说话人分离——配音前的素材处理在应用内完成,不用另开降噪或分轨工具。
- 本地接口与自动化——提供本地 API、MCP 服务、可复用配方与监听文件夹,方便接进自己的流程。
使用场景
它适合「手上有素材、要反复产出音频、并且在意素材不外流」的用法:自媒体的口播配音、课程与产品视频的多语版本、有声书批量合成、访谈与会议的本地转写。反过来说,如果你只需要一次性的文字转语音、机器内存又只有 8GB 出头,装上它再下模型会显得重;纯粹想在手机上随手转写的人,预览版的移动端也不算成熟。
| 人群/角色 | 场景描述 | 推荐指数 |
|---|---|---|
| 短视频与口播创作者 | 克隆自己的音色批量生成口播,改稿重录不必再对着麦克风念一遍 | ★★★★★ |
| 课程与产品本地化 | 一条视频转写后翻译成多语,按说话人分段重配音,时间轴自动对齐 | ★★★★☆ |
| 有声书与播客制作 | 章节文本排队合成,配合批量队列与统一导出,一次跑完几十条 | ★★★★☆ |
| 会议与访谈整理 | 用本地转写把长音频出成带说话人标注的文稿,素材不离开本机 | ★★★★☆ |
| 需要商用授权的团队 | 免费版模型许可参差,做客户项目要买 Pro 并逐个核对模型条款 | ★★★☆☆ |
操作指南
从下载到生成第一条语音,路径不长,主要时间花在等模型下载与首次编译上。把这几步按顺序走完,后面就是反复调用。
- 打开 VoiceStudio 仓库页,在 Releases 里挑对应平台的安装包,或到产品官网按 Windows、macOS、Linux、Android、iOS、Docker 选入口。
- Windows 直接跑 `VoiceStudio-<版本>-win-x64.exe`,默认装到当前用户目录、不需要管理员权限;macOS 用 `.dmg`,若提示「已损坏」是 Gatekeeper 拦截,按站内说明解除隔离即可。
- 首次启动会自己补齐 Python、FFmpeg 与运行环境,预留约 10GB 磁盘;引擎环境默认装在应用数据目录下,单个引擎可能到几个 GB,想换盘就提前设 `OMNIVOICE_ENGINES_DIR` 环境变量。
- 进「模型管理」选引擎再下权重。应用在下载前会先征求同意;没有独显也能跑,只是慢,官方说约 8GB 内存足够起步。
- 做克隆:进「语音克隆」,挑一个自带示例音色或新建音色,丢进一段干净参考音频,确认转写文本框已有内容再合成——文本框空着会让它每次生成都重跑一遍识别,明显变慢。
- 做配音:进「视频配音」,导入视频后先转写,再选目标语言翻译,按说话人核对分段与时间轴,最后导出。
- 需要边写边听就开听写浮窗;成批的文本走「批量队列」,把任务排好后统一导出。
- 想接自己的程序,走本地 API 或 MCP;配方与监听文件夹能把「丢文件→自动处理」串成固定流程。
(第 3 步之后如果觉得慢,先看「设置 → 性能」里的设备一栏是真在跑 CUDA、MPS 还是掉回了 CPU;第一次生成总是最慢,权重加载与内核编译都要时间,从第二次开始看速度才准。)
支持平台
桌面端是主力:macOS(Apple Silicon,走 Metal)与 Windows 10/11 x64(NVIDIA CUDA,可选 AMD ROCm,也可纯 CPU)都是稳定版,Linux x64 提供 AppImage、deb、Snap 与 Nix 四种装法。Docker 镜像在 GHCR,支持 CUDA 与 ROCm,适合放到服务器上跑。移动端是预览状态:Android 10+ 用 apk,iPhone 与 iPad 需 iOS 17+ 并侧载 ipa,都是端上离线推理。Windows on ARM 属实验支持,Intel Mac 受限,只能跑界面并连远程后端。
产品定价
桌面版免费,开源许可为 AGPL-3.0,没有账号也没有用量表,官方明确说它背后没有付费云服务。需要商业条款的人走 Pro:牌价 199 美元一年,目前发布价 99 美元一个用户一年,含商业许可、3 台设备、3 路并发,7 天内可无理由退款;另有终身版,牌价 499 美元,发布价 199 美元一次性,含后续更新。团队规模更大走企业定制。托管云(Cloud)标的是即将上线,价格与商业条款未公布。赞助从每月 100 美元起,买的只是展示位,不换功能。
常见问题
Q:音频会不会上传?断网还能用吗?
不会上传。官方说明它没有账号、没有云端,只在检查更新或下载模型时联网,其余推理都在本机完成。断网状态下已装好的模型照常工作,只是不能拉新权重。
Q:免费版和 Pro 差在哪,会不会突然收费?
免费版是完整的开源桌面应用,功能上并不阉割到不能用的程度;Pro 与终身版是另一套闭源构建,卖点是商业许可与额外功能,面向要交付客户项目的人。退款政策是 7 天无理由,续订可随时取消。
Q:宣称的 646 种语言包含哪些?克隆别人的声音合规吗?
语言数量取决于所选引擎与任务,官方自己在对比表里把这一行标成「引擎相关」,并没有承诺每款引擎都覆盖全部语种。克隆方面官方写明需征得声音所有者同意,冒用他人身份属于禁止用途;此外应用与模型是两套许可,示例中的 OmniVoice 预训练模型就带非商用条款,买 Pro 也不改变这一点。
开发者小结
VoiceStudio 把「本地跑语音模型」从一堆脚本变成了一个能交付给非技术同事的应用:克隆、设计、配音、听写、批量队列与导出都在同一个界面里,模型按需下载而不是一次性拖几十 GB,本地 API 与 MCP 又给愿意写代码的人留了口子。它适合需要在隐私边界内反复产出音频的个人与小团队,也适合想把语音能力接进自己工具链的开发者。不适合只做一次性转写、或设备只有 8GB 内存又要跑大模型的人。真正需要留意的是许可:应用是 AGPL-3.0,模型各有各的条款,做商业项目前要把准备使用的那几个模型逐一核对,别默认「开源就等于可商用」。
相关文章


