

日常工作中,经常会遇到需要把截图、扫描件、纸质文档或其他图片中的文字重新整理成可编辑文本的情况。手动输入不仅耗费时间,遇到表格、标题和段落较多的文档时,整理过程也比较繁琐。LlamaOCR 是一款基于OCR技术的在线文档识别工具,主要用于将图片中的文字提取出来,并转换为结构化的Markdown文档。用户只需要上传图片,就可以获得可继续编辑和整理的文本结果。对于需要处理资料、整理笔记、数字化文档或制作Markdown内容的用户来说,这种图片转结构化文本的方式可以减少重复录入工作。
LlamaOCR是什么?
LlamaOCR 是一款在线OCR文档处理工具,主要功能是识别图片中的文字,并将识别结果转换成Markdown格式。其技术方案基于Llama-ocr和Together AI,为用户提供从图片上传到文本转换的处理流程。与只输出普通纯文本的OCR工具相比,LlamaOCR更加关注结构化Markdown结果,方便用户继续进行编辑、排版和整理。对于扫描文档、收据、合同、笔记等图片资料,可以先通过OCR提取内容,再根据实际需求进行人工校对。
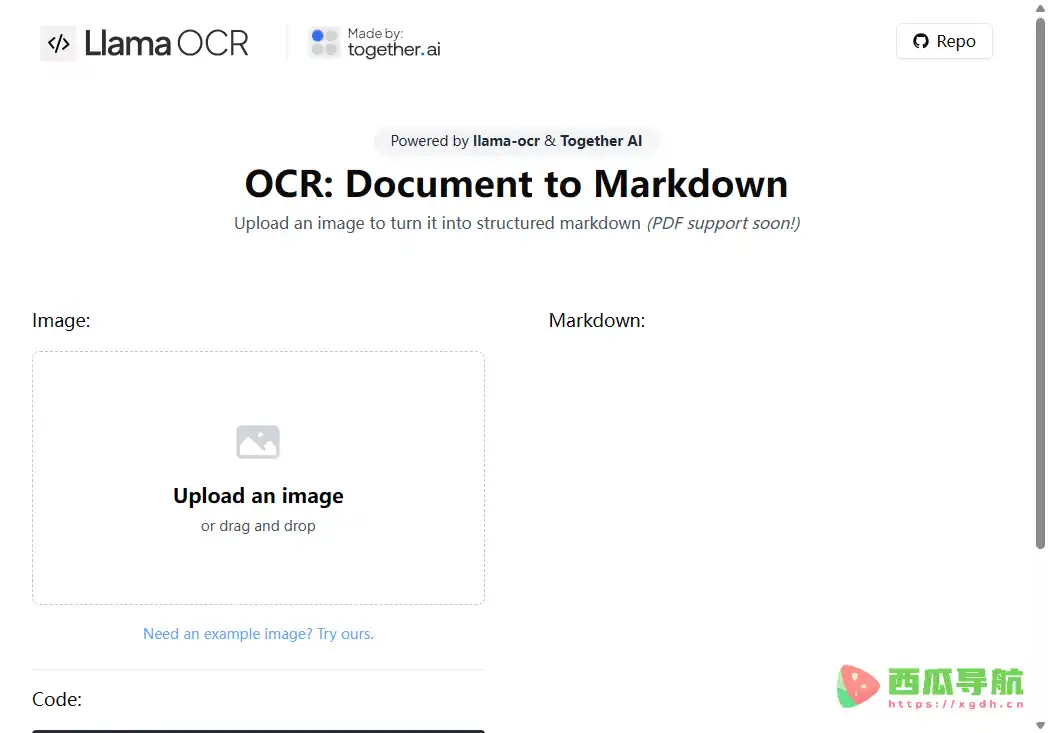
核心功能
LlamaOCR 的功能主要围绕图片文字识别和结构化输出展开。用户可以直接上传图片进行转换,也可以结合API将OCR能力应用到自己的项目中。对于希望快速把图片资料转换为Markdown的用户来说,操作流程相对直接。
- 图片OCR识别——自动读取图片中的文字内容,减少手动输入和复制的工作量。
- Markdown输出——将识别后的内容整理成Markdown格式,方便继续编辑和发布。
- 图片拖放上传——支持直接上传或拖放图片,简化文档转换前的准备步骤。
- 结构化处理——在文字识别的基础上尽可能保留文档中的内容层次,方便后续整理。
- 结果复制——识别完成后可以查看生成的Markdown文本,并复制到其他编辑工具中使用。
- API支持——开发者可以利用相关API将图片识别能力集成到自己的应用或工作流程中。
- 多场景文档处理——可以用于扫描资料、收据、合同、笔记等不同类型的图片文字提取。
使用场景
LlamaOCR 更适合需要把图片资料快速转成可编辑文字的用户。尤其是在资料数字化、Markdown笔记整理和内容创作等场景中,先通过OCR完成基础文字提取,再人工校对和加工,可以减少重复录入工作。
| 人群/角色 | 场景描述 | 推荐指数 |
|---|---|---|
| 学生及研究人员 | 将书籍、论文资料或课堂笔记图片转换成可编辑文本 | ★★★★☆ |
| 内容创作者 | 将截图、手稿或图片资料整理成Markdown内容 | ★★★★★ |
| 办公人员 | 提取合同、票据、会议资料中的文字信息 | ★★★★☆ |
| 商家及财务人员 | 识别收据、发票等图片中的基础文字内容 | ★★★★☆ |
| 开发者 | 通过API将OCR识别能力接入自己的应用或自动化流程 | ★★★★★ |
| 普通用户 | 将手机照片或扫描文档中的文字快速转换出来 | ★★★★☆ |
操作指南
使用 LlamaOCR 不需要安装复杂的软件,新手可以直接通过浏览器完成图片识别。准备好需要处理的图片后,上传文件并等待系统完成OCR处理即可。识别结果生成后,建议先检查文字内容,再复制到Markdown编辑器或其他工具中继续修改。需要使用时,可访问 LlamaOCR 进入在线工具。
- 打开工具:使用浏览器进入 LlamaOCR 页面,等待在线工具加载完成。
- 准备图片:选择需要识别的扫描件、截图、照片或其他文档图片。
- 上传文件:点击「上传图片」,或者将图片直接拖放到指定区域。
- 开始识别:完成上传后等待系统自动进行OCR处理。
- 查看结果:识别完成后,在结果区域查看转换后的Markdown文本。
- 检查内容:重点检查数字、专有名词、表格和格式等容易出现识别误差的内容。
- 复制使用:确认结果后,将Markdown文本复制到笔记、编辑器或其他文档工具中。
- 开发者调用:如果需要批量处理,可以进一步根据相关API说明进行集成。(涉及重要资料时,建议保留原始图片并人工核对OCR结果。)
支持平台
LlamaOCR 属于基于网页的在线工具,用户通过浏览器即可访问,不需要额外安装桌面软件。它可以在常见的电脑操作系统和移动设备上使用,只要设备具备兼容的浏览器和网络连接即可完成图片上传与文字转换。实际使用体验会受到浏览器、图片大小以及网络环境等因素影响。
产品定价
根据提供的资料,LlamaOCR 提供免费的基础OCR服务,用户可以直接使用图片识别和Markdown转换功能。未来如果增加高级功能或其他服务,具体收费方式应以产品实际页面公布的信息为准。
常见问题
1. LlamaOCR可以识别什么类型的图片?
它主要用于处理包含文字的文档图片,例如扫描件、截图、收据、合同和笔记等。实际识别效果会受到图片清晰度、文字布局和图片内容等因素影响。
2. OCR转换后的Markdown需要检查吗?
建议检查。OCR属于自动识别过程,数字、符号、特殊字体以及复杂排版都有可能出现识别偏差。用于正式文档或重要资料时,应以原始图片为依据进行人工核对。
3. LlamaOCR适合开发者使用吗?
适合有程序集成需求的用户。资料显示它提供API支持,开发者可以根据相关接口说明将图片文字识别能力接入自己的应用或自动化工作流程。
开发者小结
LlamaOCR 的定位比较明确,主要解决图片文字提取以及Markdown结构化整理的问题。对于需要处理扫描文档、截图、收据、合同和笔记的人来说,它可以减少手动录入的时间,并让识别结果更容易进入后续编辑流程。Markdown输出也是它比较适合知识管理和内容创作场景的地方。开发者还可以利用API进行进一步集成。不过,OCR识别并不意味着所有内容都能准确还原,复杂排版、低清晰度图片和特殊字符仍可能需要人工调整。因此,LlamaOCR 更适合作为文档数字化和文字整理的辅助工具,而不是完全替代人工校对。
相关文章


